DeepSeek Harness(下称 DSH)的 Provider schema 其实相当完整:重试、超时、请求头、图片预算、思考档位、二十多个兼容性开关……但其中一多半在界面上没有入口,只存在于 profile 的
cordis.patch.yml里。我做的 Advanced Provider Settings 插件把这些字段做成了看得见、点得到的设置面板,并且把「模型」变成了面板的主角。这篇主要讲三张截图对应的三块:按模型配置、带退避曲线的重试策略、视觉与推理预算,其余面板最后也一并过一遍。当前版本 v0.4.5,已在 DeepSeek Harness 0.1.7-alpha.1 上验证。
为什么需要它
DSH 开箱最不擅长的场景,恰恰是把 Harness 指向一个第三方 DeepSeek 端点——云上的聚合网关、公司代理、nginx 后面自建的 vLLM。DSH 的兼容性是按 Provider id 与 baseURL 探测的,只有 URL 里含 deepseek.com 的主机才会被认成 DeepSeek,其余一律拿到一套 OpenAI 形状的默认值。于是你选的思考档位被打包成端点看不懂的形状、该发 max_tokens 的地方发了 max_completion_tokens、厂商根本没实现的 store 字段照发不误。
最要命的是,这一类配置失败的时候一声不响:配置时没有任何报错,只是请求并没有按你选的档位去做。而这些真正决定行为的字段——重试怎么退、图片多大要拦、思考方言是哪一种——原本都只能手改 ~/.dsh/profiles/<profile>/cordis.patch.yml。
这个插件不改变这些字段的归属,只是把它们呈现出来:不改 Harness 一行源码、不 patch node_modules、不保存第二份配置,读写走 DSH 公开的 settings API,写入是按路径的最小操作——你的 YAML 保留注释,没动过的字段原样保留。
按模型配置:档位映射真的能落到线上
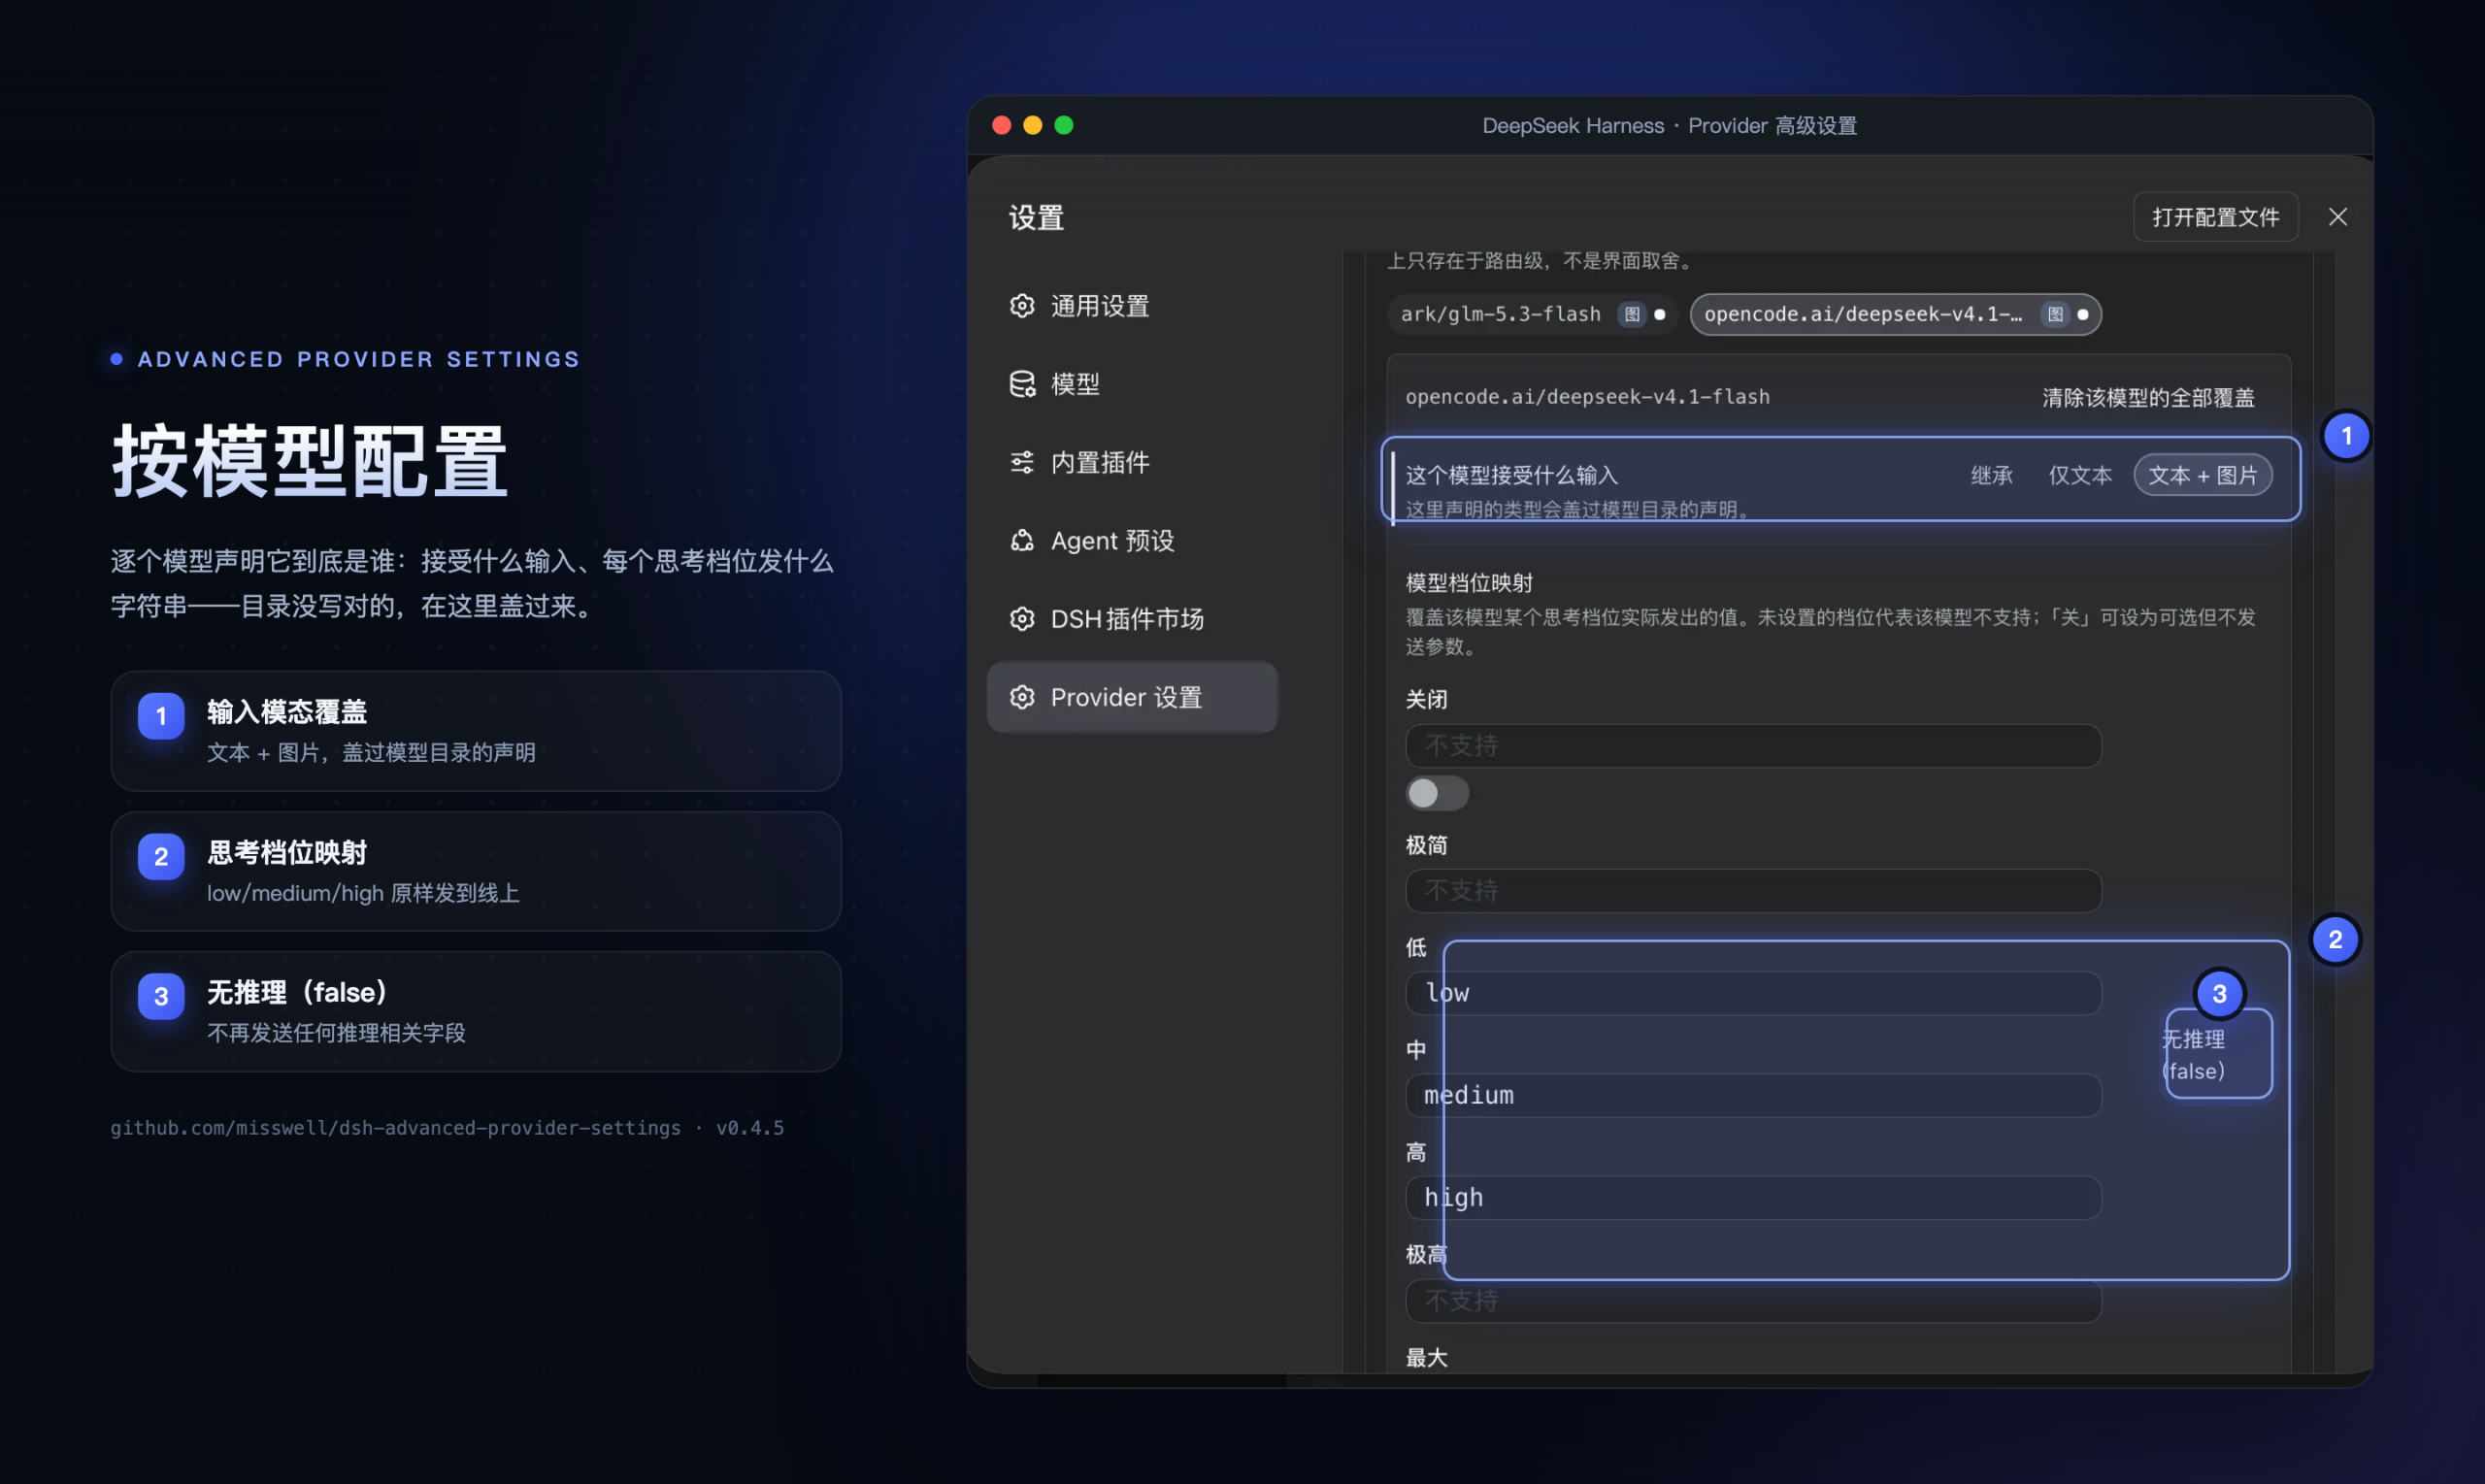
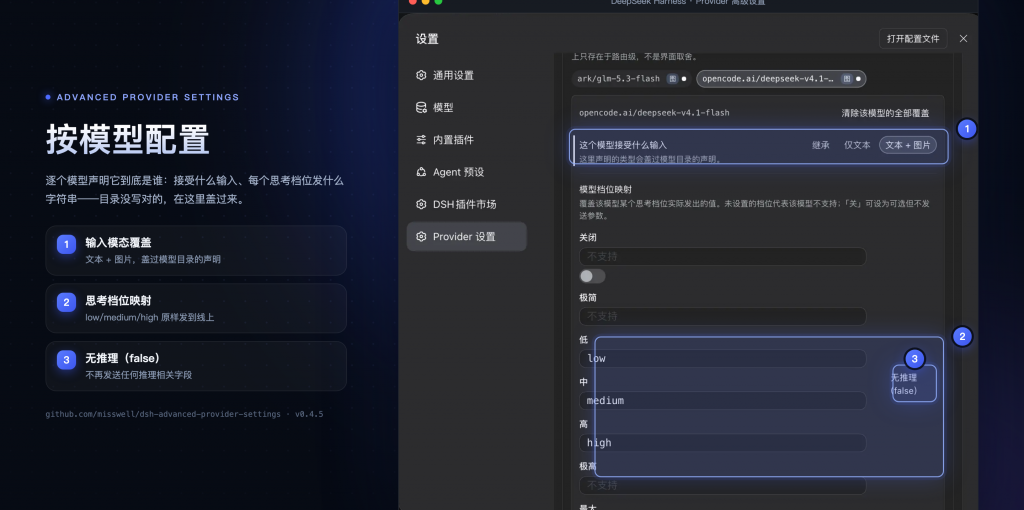
「按模型配置」一次只编辑一个模型。顶部一排模型胶囊,带「图」标记的表示它声明了图片输入,右侧的小圆点表示这个模型身上已经有覆盖——不点开也知道哪里配过。截图里的 opencode.ai/deepseek-v4.1-flash 就是一个被我手动声明过覆盖的模型。
第一行声明这个模型接受什么输入:继承、仅文本、文本 + 图片,这里声明的类型会盖过模型目录的声明。目录里没说它能收图,就在这里手动打开「文本 + 图片」。
往下是模型档位映射,它回答的问题是:这个模型管某一档思考叫什么。阶梯是 off → minimal → low → medium → high → xhigh → max,每一格里填的字符串,就是这一档实际发到线上的值。截图里 low、中、高都映射到同名档位,关闭、极简、极高留空——留空代表该模型不支持这一档,请求点名它会得到一个带名字的错误,而不是被悄悄丢掉。如果这个模型根本不推理,点右侧的「无推理(false)」,Harness 就不再为它提供任何推理控件,也不发任何相关字段。
另外,路由用内置模型目录时,按模型配置走的是 modelOverrides.<id> 通道,同一个编辑器还负责改这个模型的显示名称、上下文窗口与最大输出 token——因为那条通道没有别的编辑器。
重试策略:先看见形状,再决定数字
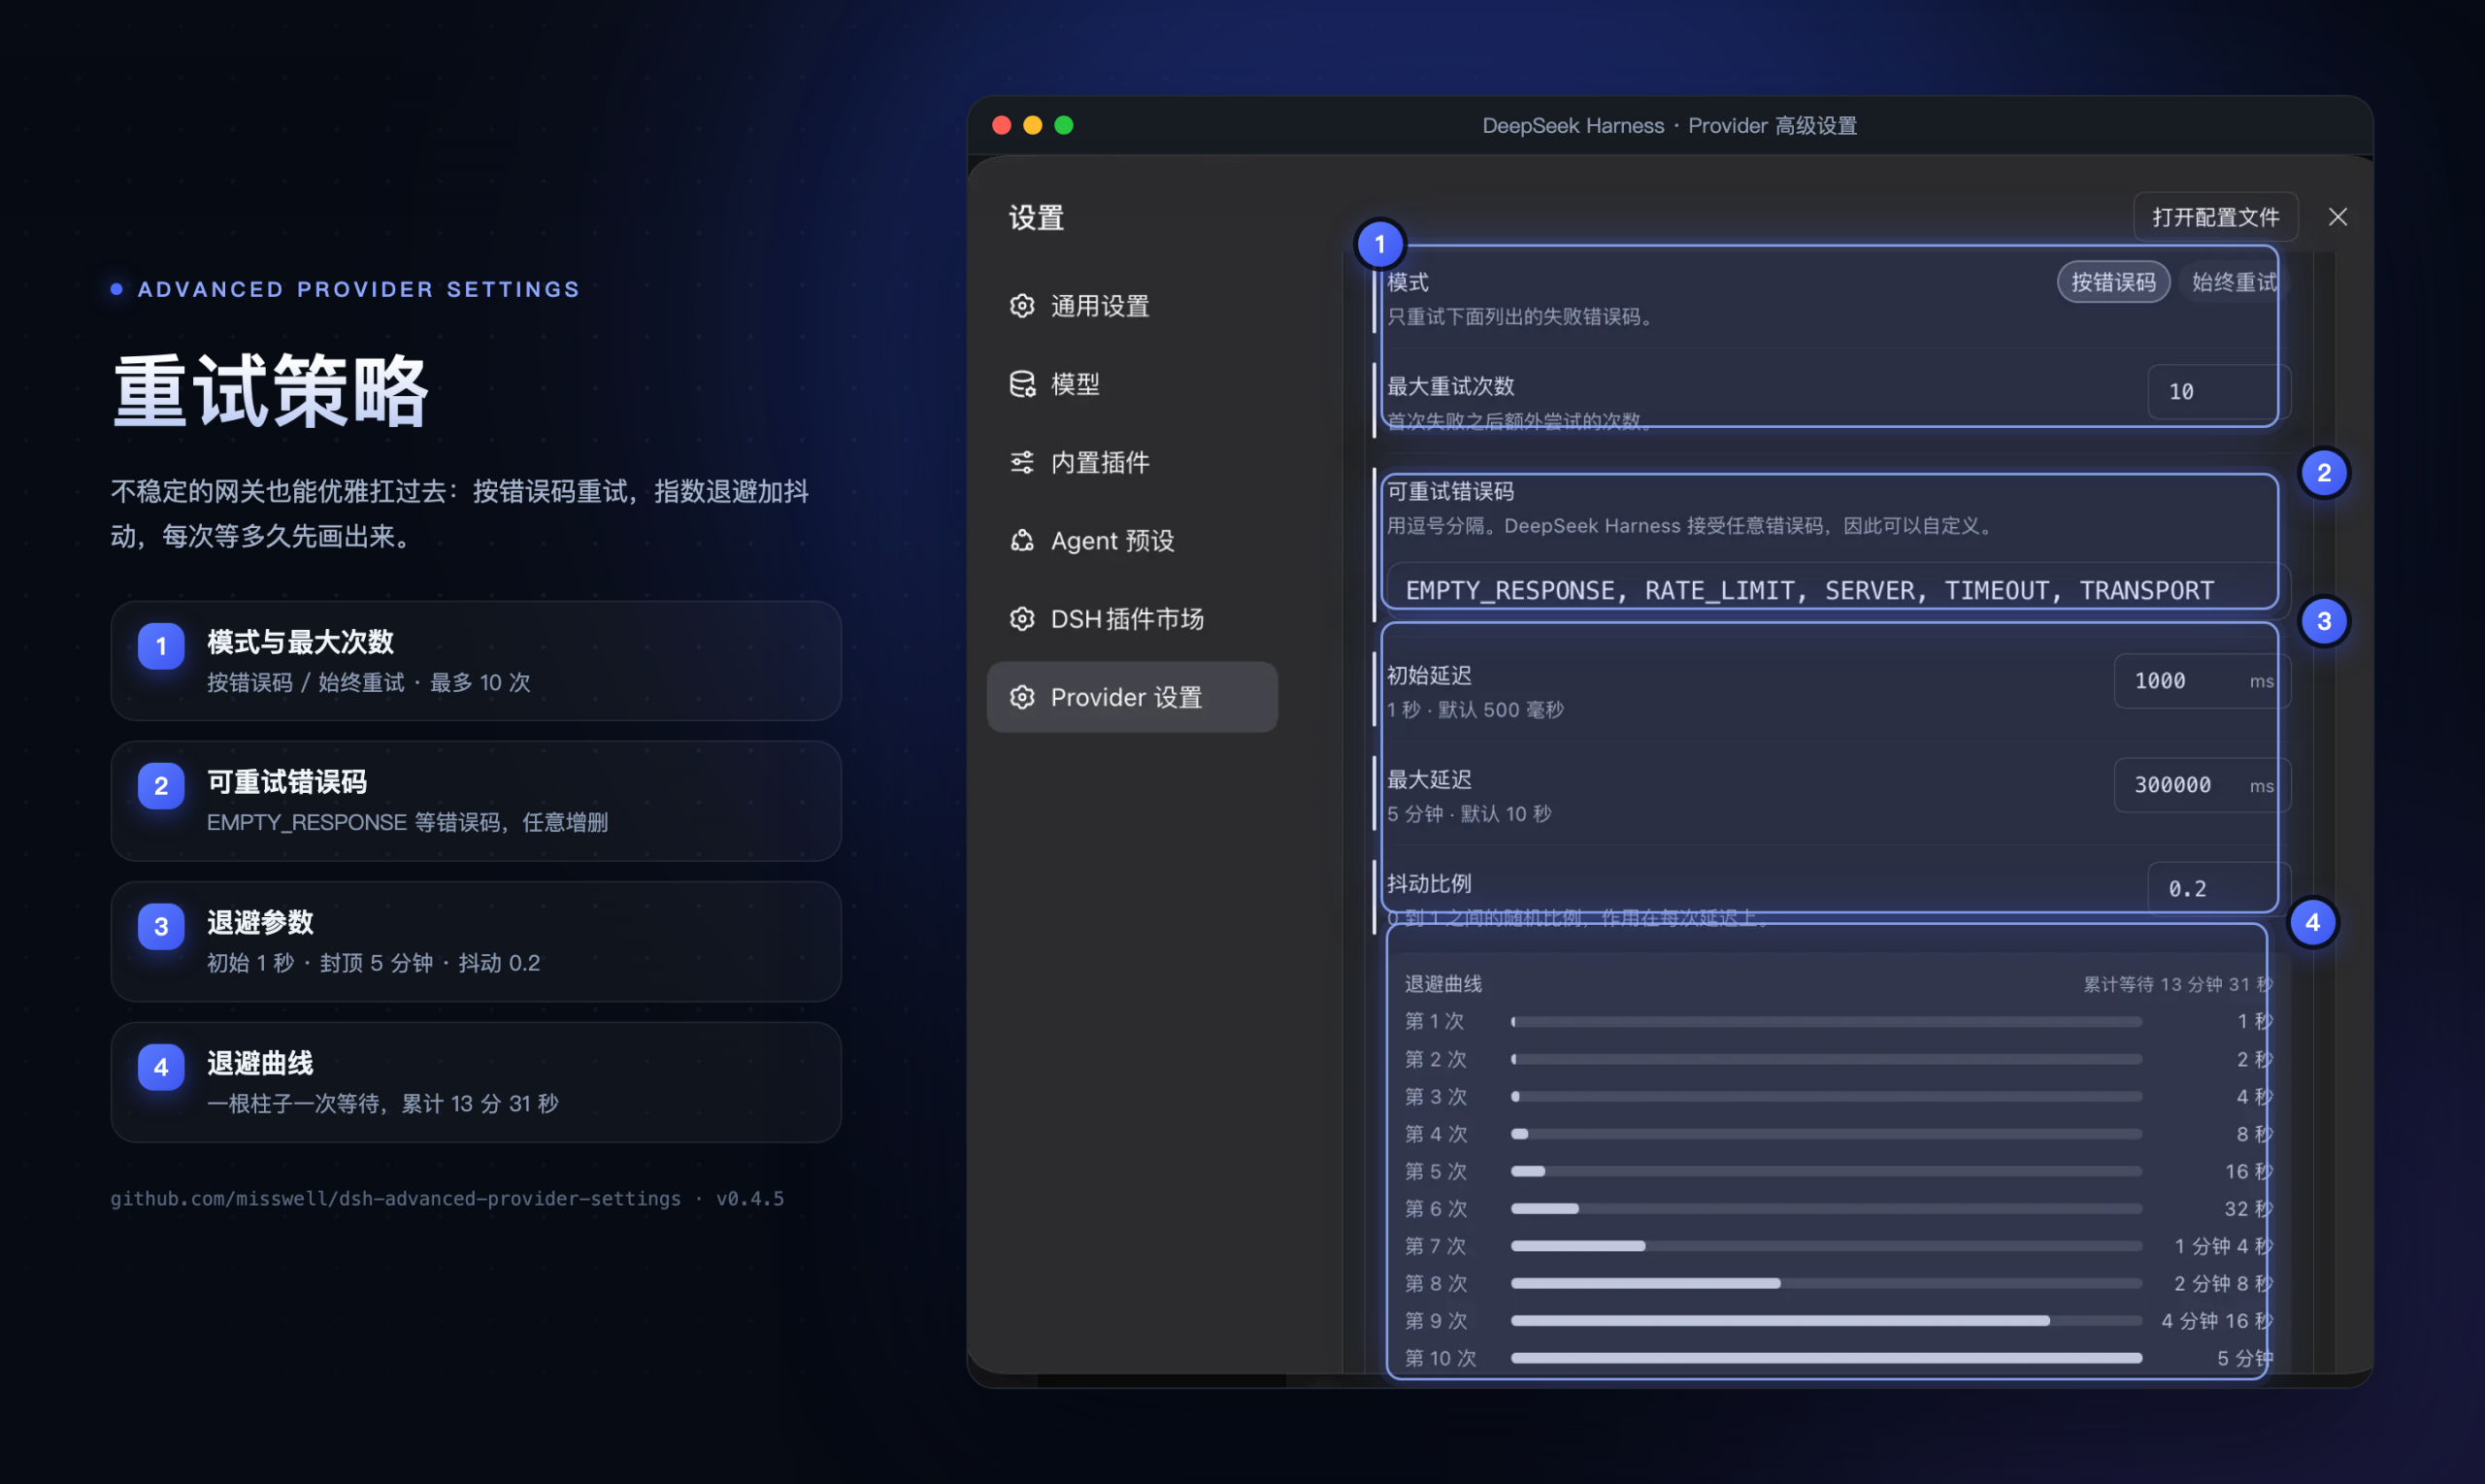
重试永远是路由级的——既没有按模型的重试,也没有全局重试。插件给了 Harness 默认 / 保守 / 激进三档预设,也可以完全自定义:模式(按错误码 / 始终重试)、最大重试次数、可重试错误码、初始延迟、最大延迟、抖动比例。错误码可以任意增删,因为 Harness 接受任意错误码。
截图里是我的实际配置:只重试 EMPTY_RESPONSE、RATE_LIMIT、SERVER、TIMEOUT、TRANSPORT 这五类错误,最多重试 10 次,初始延迟 1 秒、封顶 5 分钟、抖动比例 0.2。底下那根退避曲线把这些数字画成形状——每次重试一根柱子,长度对应真实等待时间,右上角给出累计等待 13 分 31 秒。「重试 4 次、500 毫秒、翻倍、上限 8 秒」是一种形状,看成一张图更容易判断合不合理。
视觉与推理:预算先于请求
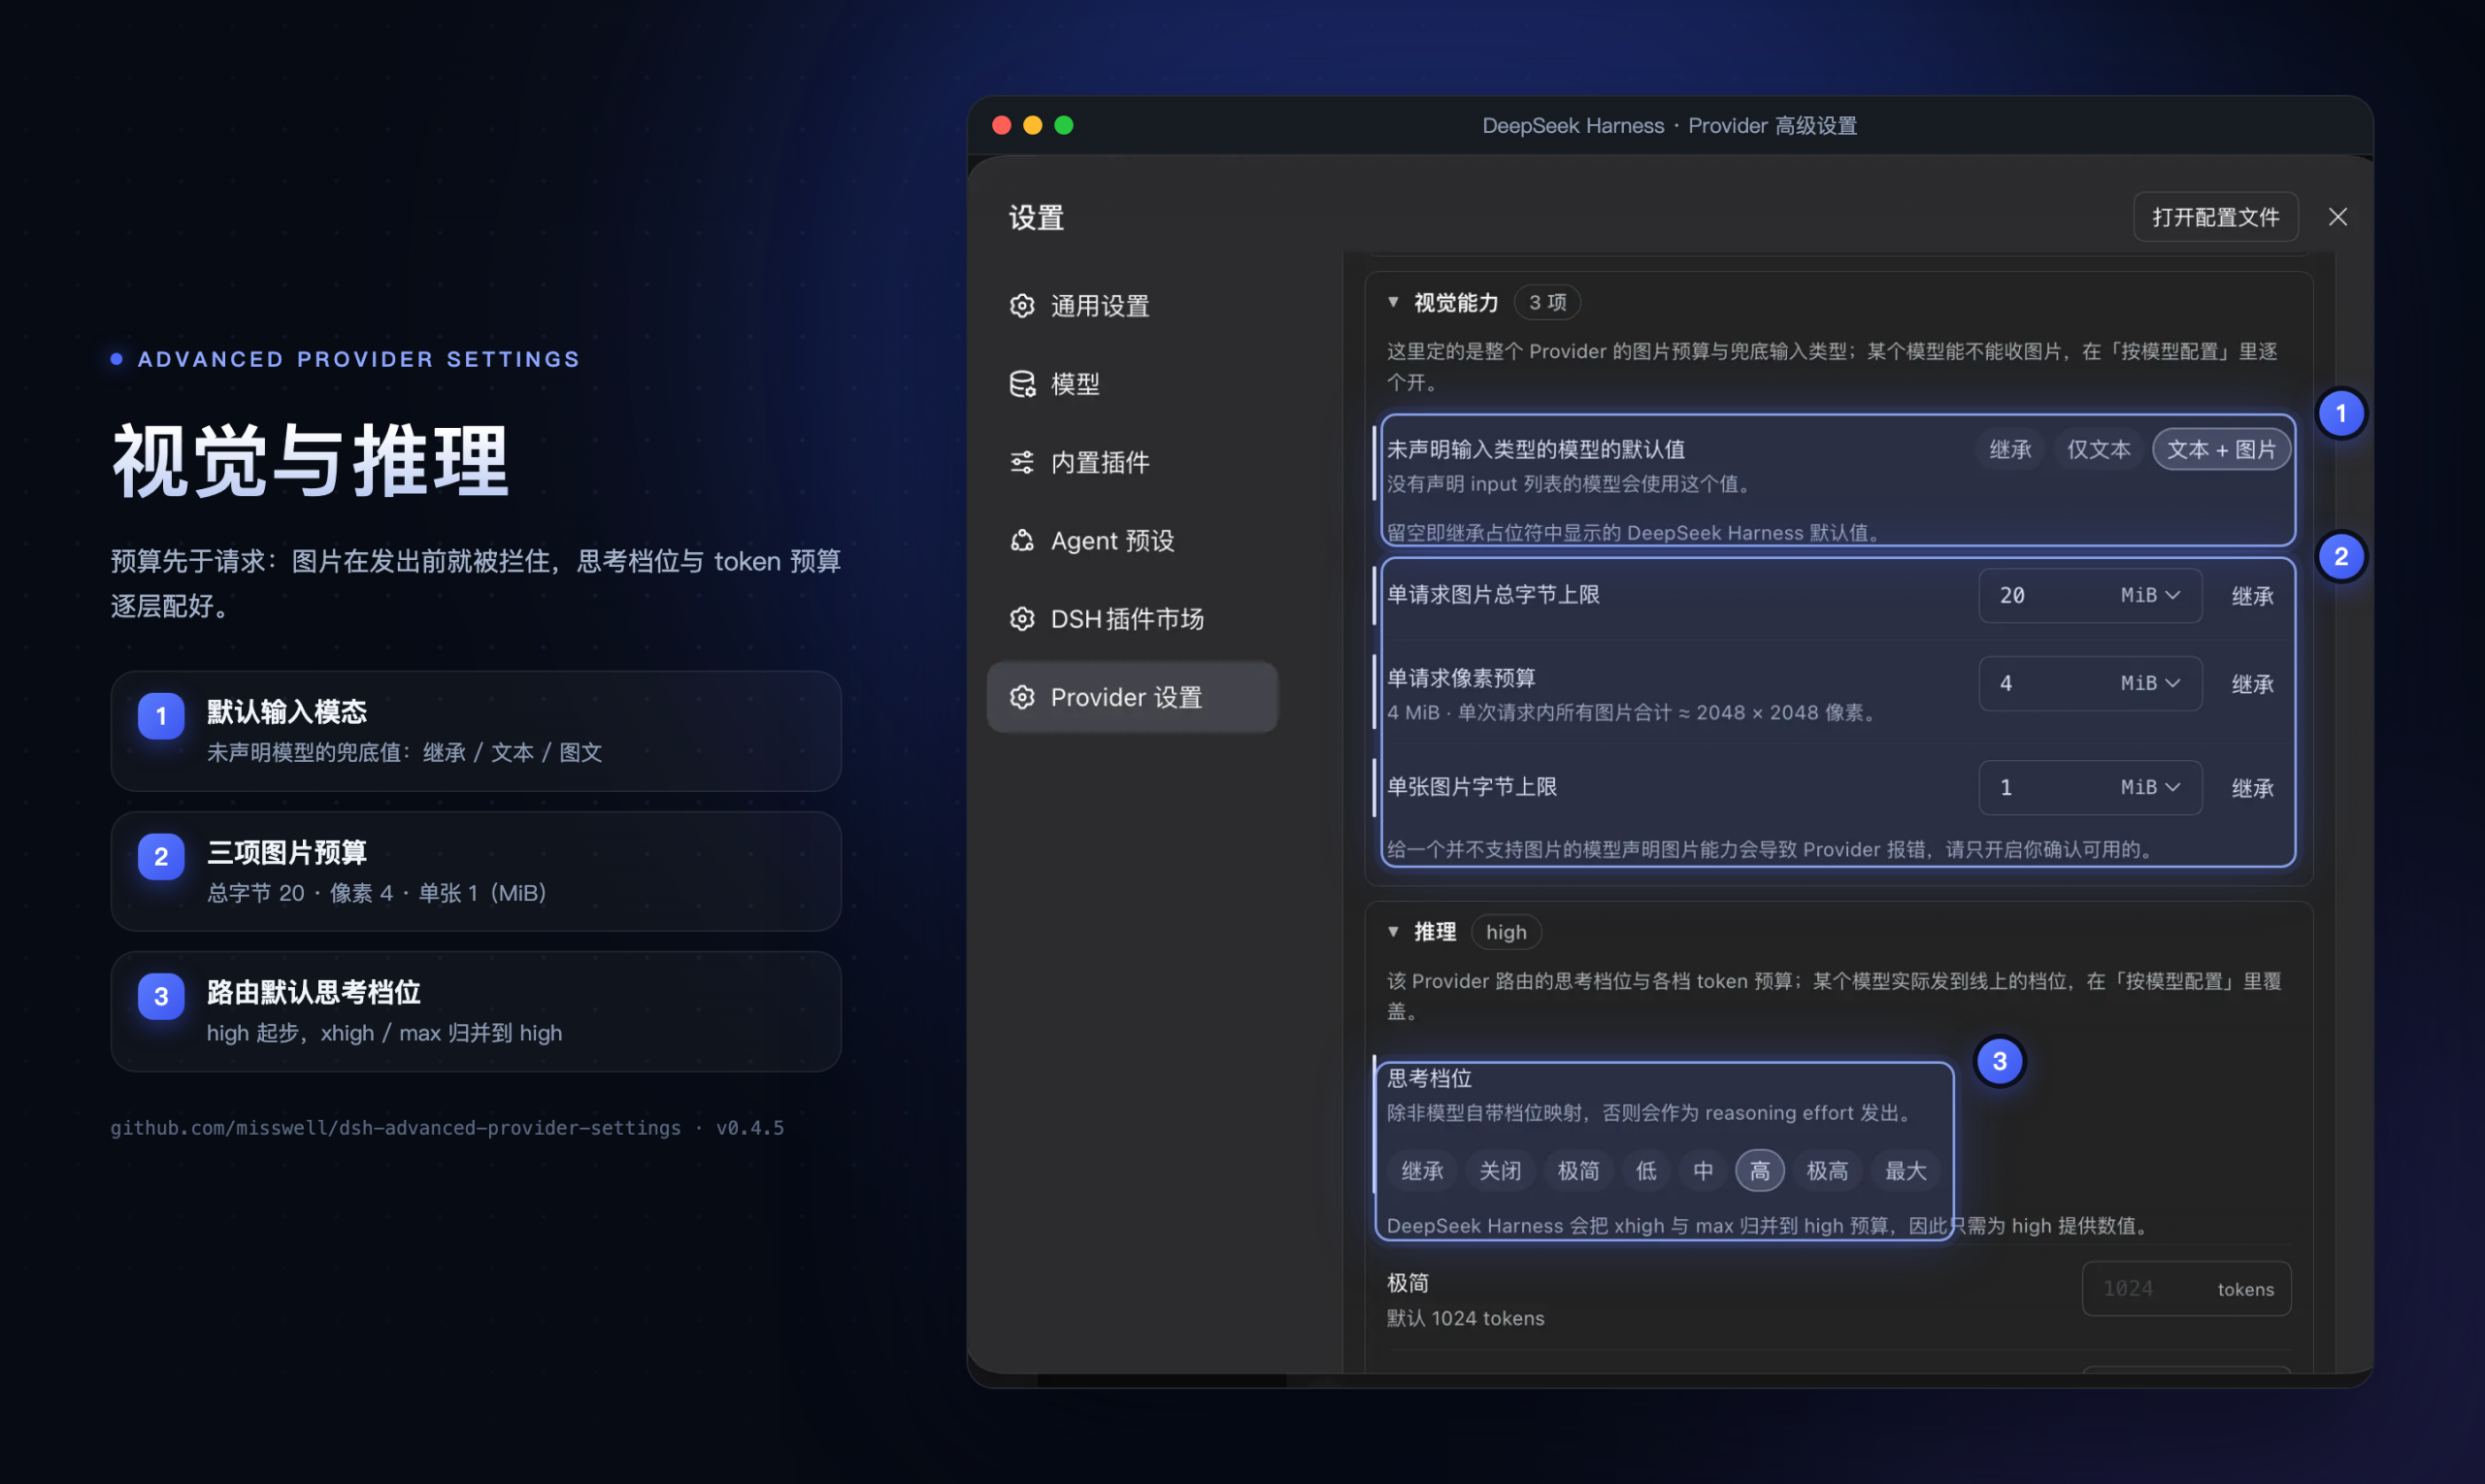
视觉能力是 Provider 级的,共三项预算加一个默认值:未声明输入类型的模型的默认输入模态(截图里是「文本 + 图片」)、单请求图片总字节上限(20 MiB)、单请求像素预算(4 MiB ≈ 2048 × 2048 像素)、单张图片字节上限(1 MiB)。单位全部用 MiB 说话,差 1000 倍这种错误一眼就能看出来。某个模型能不能收图,则回到「按模型配置」里逐个开——给一个并不支持图片的模型声明图片能力,只会让 Provider 报错。
推理卡片配的是路由级默认思考档位(截图里是 high)与各档 token 预算。xhigh 与 max 虽然 schema 接受,但在请求发出前会被归并到 high 的预算上,所以真正要填的只有 high 一档,卡片直接用文字说明这一点,而不是给出一档实际不存在的粒度。预算还会被钳到这次请求留给答案的空间:输出上限只有 8000 的请求,配 32000 的预算最终就是 8000。
有一个值得注意的边界:路由默认档位会拿去跟实际收到请求的模型校验,模型不支持的档位不会被降级,而是直接抛 UNSUPPORTED_REASONING_EFFORT。所以在同时挂着推理与非推理模型的混合路由上,请把这一档留在「继承」,让每个模型自己的映射去决定。
其余面板
- Headers:全局与 Provider 级请求头,带校验、密钥掩码与重名检测。两个坑会主动警告:Provider 级的
user-agent会被 Harness 剥掉、再发它自己的归属标识(只有全局层能真正生效);自己配的authorization会顶掉 API Key。 - User-Agent:Chrome、Safari、Firefox、opencode、Codex CLI、Claude CLI 预设加自由输入,给有客户端白名单的网关用。
- 网络:传输方式(
sse/websocket/websocket-cached/auto)、请求超时、流空闲超时、WebSocket 连接超时、缓存保留策略。 - 兼容性:全部 26 个
compat开关,并按该路由协议实际会读取的字段过滤——包括思考方言(deepseek、openai、openrouter、qwen、chat-template等)与承载思考预算的字段名。每个开关三态:继承 ≠ 关闭。 - 测试 Provider:用表单里当前(无论是否已保存)的 Headers 去请求端点的模型列表,是验证白名单 Header 是否生效最快的方法。
- 生效配置 / 诊断:逐层展示这个 Provider 实际会发出什么(敏感值已掩码);诊断面板输出只读兼容性报告,可直接粘进 issue。
安装
需要 DeepSeek Harness 0.1.7 及以上。Web UI 用 CLI 安装:
dsh plugin --profile web add github:misswell/dsh-advanced-provider-settings桌面版在应用的「插件市场」里安装 misswell/dsh-advanced-provider-settings,重启即用。两个 profile 跑的是同一个产物,机器上不需要构建。
项目在 GitHub 开源(MIT):misswell/dsh-advanced-provider-settings。更多细节——按模型的第二条通道、思考方言的具体行为、安全设计——都在 README 里;遇到配不出来的形状,欢迎带上诊断面板的报告提 issue。